考える脳と実行する脳の二層構造
現実世界で起こった事象を把握し、フィジカルAIがどのような「判断・決定」を行うのか。ソフトバンクが安川電機と物流倉庫で行った実証では、判断・決定と、それに基づく動作生成の場所を分離している。
実証はスマートフォンの出荷作業を想定したもので、ロボットが指示に従ってスマートフォンとアクセサリーをコンテナから取り出し、台車の上に載せるタスクをこなす。その作業中、スマホの上に保護フィルムが重なって置かれているという、事前学習にはない想定外の状況を設定した。
AIが導き出した解決プロセスはこうだ。
重いスマホを先に出して台車に載せたいが、上に保護フィルムがあることを把握したAIは自ら手順を分解し、まず保護フィルムをコンテナ内の別の場所に避けて、その後にスマホ、保護フィルムの順に取り出すという指示を生成した。ロボットはこの手順に従って、自律的にタスクを完遂した。
この実証で、ソフトバンクは図表2のようにAIの処理を分散させている。高次判断を担う「VLM(Vision Language Model)」と、制御情報生成を行う「VLA(Vision Language Action)」の2層構造だ。
図表2 ソフトバンクと安川電機の実証におけるAIの展開先
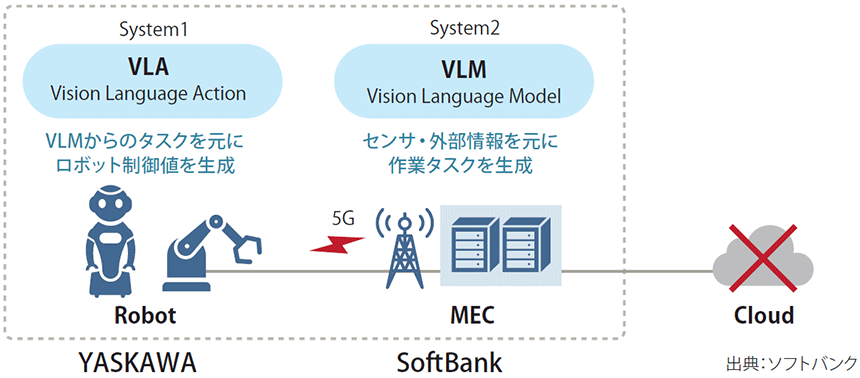
VLMは、画像や動画等の視覚情報とテキストを統合的に処理するマルチモーダルAIだ。これが、現場を写したカメラ映像やユーザーの指示に基づいて、高次判断やタスクの生成・分解を行う。
この考える脳は、いわゆるMEC(マルチアクセス・エッジコンピューティング)への配置を想定している。具体的には基地局設備にGPUリソースを配備するAI-RANや、同社が「リージョナルブレイン」と呼ぶ地域データセンターだ。
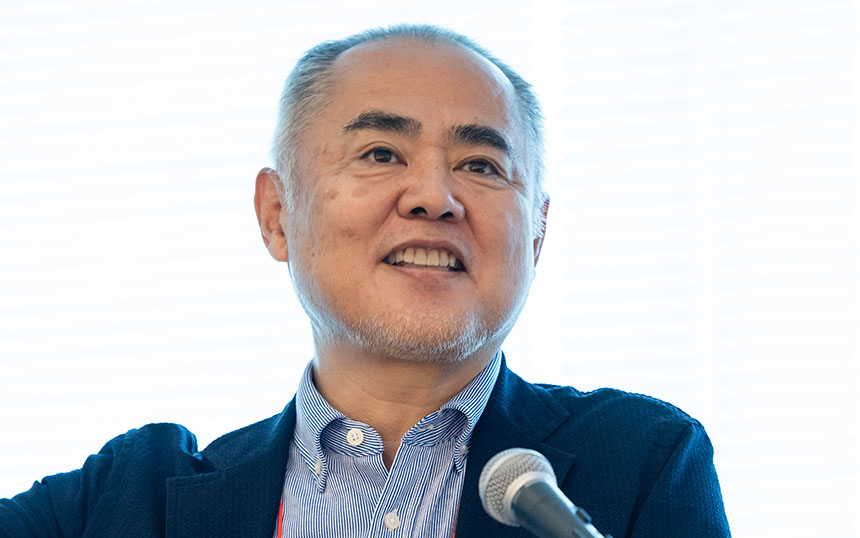
ソフトバンク 技術統括共通プラットフォーム開発本部 先端AIプラットフォーム統括部 統括部長の山科瞬氏は「大規模なAIモデルを効率的に動かすこと」をその理由に挙げる。これにより、「人間に近いマルチタスク能力、24時間稼働する能力、想定外事象への対応能力を実現できる」。
ソフトバンク 技術統括 共通プラットフォーム開発本部 先端AIプラットフォーム統括部 統括部長の山科瞬氏
VLAはその判断・指示を受け、具体的なロボットの制御情報(関節の角度等)を生成する。場所は、ロボット内。低遅延な物理制御を実現するためだ。
応答性を重視した機能分離を
ここで1つ、疑問が湧く。ロボットとMECとの間のネットワーク遅延は、VLMの判断に悪影響を及ぼさないのか。
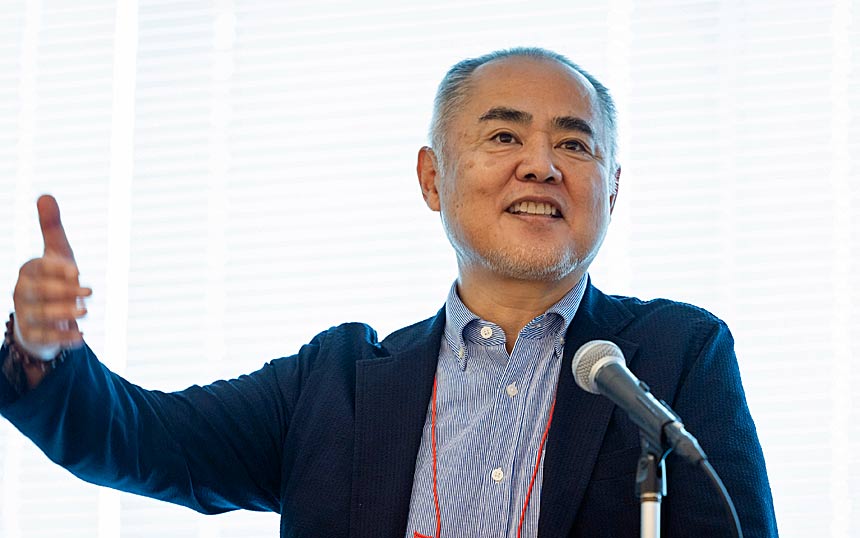
山科氏によれば、高次判断を行うために80億パラメーターのモデルを動かす場合、ロボットに搭載されるNVIDIA Jetson等の組み込み型小型コンピューターでは、処理遅延がかえって大きくなったという。潤沢なリソースが使えるMECで処理したほうが、トータルでは高速になる。「エンドツーエンドのTTFT(Time To First Token)は、MECで処理した方がむしろ高速だった」。
なお、クラウド環境でも平均値はMECと近い数値が出たものの、遅延のゆらぎが大きく、ロボット制御には不向きであると判断したという。ソフトバンク 技術統括 共通プラットフォーム開発本部 先端AIプラットフォーム統括部 AI開発部 フィジカルAI開発課 課長の榎本光洋氏によれば、「最近の数十億~百数十億パラメーター規模のモデルは高速化しているものの、それでも推論に60~70ミリ秒程度を要する。これに通信遅延を足し合わせると、MECでなければ遅延要件を満たせないケースというのが見えてきている」。
ソフトバンク AI開発部 フィジカルAI開発課 課長の榎本光洋氏
現場環境や用途、ロボット内GPUの性能によっては、異なる機能配置ももちろん考えられる。ソフトバンクがエリクソンと実施した他の実証では、MECでVLAを稼働し、5Gの低遅延通信を介してロボットを制御した。
ネットワンシステムズ ビジネス開発本部 イノベーション推進部 ビジネス開発チームの伊藤千輝氏は、制御する機器が移動体か非移動体かによって構成や検討すべきポイントが変わると指摘する。
ネットワンシステムズ ビジネス開発本部 イノベーション推進部 ビジネス開発チームの伊藤千輝氏
産業用ロボットは有線接続が大半であるため、「ネットワークへ接続しやすく、ロボットのすぐ横にエッジコンピューティングも置くことができるが、誰が現場で運用するのかという課題が残る」。遅延要件が厳しい一方で、高信頼な有線ネットワークによってコンピューティングリソースをつなぎ合わせられるため構成の自由度は高い。「機能の配置と役割分担について検討すべき点が多い」。
一方、移動体の場合は、内部リソースで何をさせるかがポイントになる。こなせるタスクは限られることが多いため、先述の二層構造のように機能を分散配置し、無線接続によって外部のコンピューティングリソースの活用が必要になる。将来的にはデバイス内の処理能力を高め、「定期的にエッジやクラウドと通信して、モデルをロボット内部に持ってくるアーキテクチャが必要になるかもしれない」。