分散GPUの検証進む
DCI需要を押し上げる要因の1つが、計算資源の地理的分散だ。AI処理に必要なGPUが増え、1つのDCに集約して確保することが難しくなるなか、複数DCのGPUをネットワーク越しに組み合わせて使う「スケールアクロス」の構想が具体化している。
その実現には、通信が処理性能の足かせにならないことが前提となる。GPU間で大量のデータや計算結果をやり取りすると通信待ちが生じ、同期処理では一部の遅れが全体に影響する。このため、大容量に加えて低遅延、遅延のゆらぎの小ささも重要だ。こうした要件に適したネットワークとしてAPNが注目されている。
NTTドコモビジネスは2026年7月、この可能性を検証する「GPU over APN Testbed」の提供を始めた。これまで単一拠点で行ってきた処理を、APNで接続した日本各地に分散配置された複数拠点のGPUを使って実行できるかを試行する環境だ。「製造業や通信・ICT企業、研究機関などの業種からかなりの数の問い合わせが寄せられている。現在5社程度の企業と共同検証を進めており、2026年度中に10社程度まで広げる計画だ」と桑原氏は語る。
検証では、まずGPUそのものをどう確保するかという課題がある。同社では、自社保有のGPUだけでなく、利用企業側のGPUとの連携も想定する。
それ以上に重要なのが、離れたGPUを分散処理基盤として運用するためのソフトウェアによる制御だ。松林氏は分散GPUやワークロードシフトへの期待が高まる一方で「ソリューションを作るのは大変」「分散した拠点にただAPNを引けばいいという話ではない」と述べる。複数拠点で処理を分担するには、計算をどのGPUに割り当て、データや処理結果をどう受け渡すかを制御する仕組みも必要になる。つまり、ネットワークは分散処理の必要条件だが、それを実際のソリューションにするには、GPUやDC、ソフトウェアを組み合わせた設計が不可欠ということだ。
松林氏は、同テストベッドでの検証例として金利計算を挙げ、「1カ所のスパコンで行っている処理を分散して行う」と話す。こうしたHPC(High Performance Computing)を対象に、有償・無償双方のPoCを通じて実用性を探る。「分散GPUは通信が必要になるため、通信業界の関心が強い。DC事業者にもテストベッドの検証に加わってほしい」と松林氏は話す。
ワット・ビット連携にも不可欠
計算資源の地理的な分散を促す一因が電力事情だ。GPUを高密度に収容するAI向けDCは大量の電力を消費するが、需要の大きい都市部では用地だけでなく電力の確保も難しくなっている。新たな送電線や変電所の整備が必要になれば、DCへの電力供給まで計画から数年ないし10年を要する場合もある。
これに対し、系統容量に余裕がある場所に計算資源を置き、需要地と高速ネットワークで結ぶ「ワット・ビット連携」の考え方が現実味を増している。
こうした分散配置を機動的に進める手段の1つが、NTTドコモビジネスと東京電力パワーグリッド(PG)が進める「コンテナDCパーク」だ。東電PGが持つ土地や電力設備などを活用し、GPUサーバーを収容できるコンテナ型DCを配置する。系統容量に余裕がある適地なら、送電設備の新設を伴う建屋型DCより短期間で展開しやすい。ユーザー企業や他のDCとは、APNなどの高速ネットワークで接続することを想定する。
ワット・ビット連携の実現に向け、分散したデータと計算資源をネットワーク越しに連携させ、その処理性能と電力消費を検証する取り組みが進んでいる。九州電力、インターネットイニシアティブ(IIJ)、QTnet、1Finity、ノーチラス・テクノロジーズは、九州内の2拠点で2025年10月から2026年3月にかけて実証を行った。DC機能とGPUを分散配置して1FinityのAPN機器および長距離通信時の性能劣化抑止を実現する光NICで接続し、ノーチラスの分散データベース「Tsurugi」を介して、遠隔地のGPUによるローカルLLMやAI画像処理などを実行。処理性能や消費電力を検証し、データとGPUを同じ場所に置かなくても、APNを介した処理が実用になり得ることを確認した。
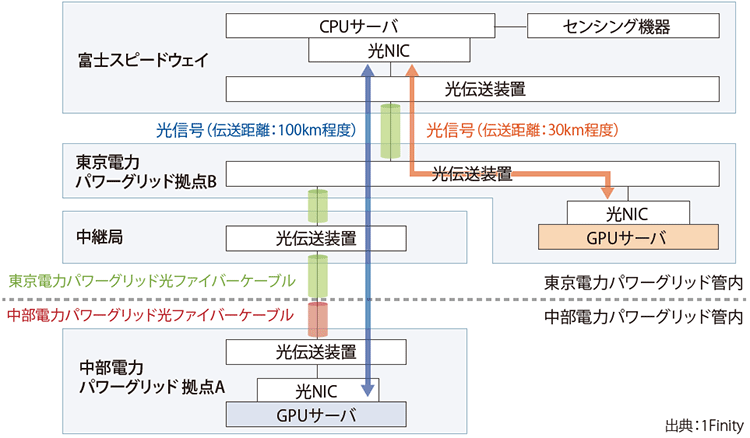
2026年8月から2027年3月にかけて進められるノーチラス、IIJ、富士通、1Finityらによる取り組みはさらに一歩進んでいる。この実証では、富士スピードウェイで開催されるフォーミュラカーレース「KYOJO CUP」を舞台に、22台の車両から4K車載映像と速度、エンジン回転数、アクセル開度などのテレメトリーデータをローカル5Gを介して収集し、富士スピードウェイ内のCPUサーバーに格納する。これを1FinityのAPN機器と光NICで約30km離れた東京電力PGの拠点と約100km離れた中部電力PGの拠点にあるGPUサーバーへ送り、サーキットの3Dデータも組み合わせてAI処理する。このインフラを活用し、AIがレース状況から判断した「最もエキサイティングな映像」を観客向けにリアルタイム配信するという。
ポイントは、同じAI処理を離れた2拠点のGPUで実行できる構成にしていることだ。実証では、東京電力PGと中部電力PGという周波数の異なる電力供給エリアに置いたGPUの稼働タイミングを制御し、電力需要の状況に応じて計算負荷を調整できる可能性を検証する(図表1)。電力のある場所にDCを置くだけでなく、分散した計算資源をAPNで一体化し、電力事情に合わせて使うという、高度なワット・ビット連携を射程に入れている。
図表1 分散型AI処理インフラ実証実験の構成