最大の違いはネットワークの「密度」
AI演算のためのデータセンター、すなわちAIファクトリーのネットワークも、現在はイーサネットで構築するのが一般的だ。だが、イーサネットといっても、キャンパスネットワークと、ハイパースケールと呼ばれるクラウドデータセンターで求められる性能、そして通信キャリア網で求められる性能は方向性が異なる。
AIファクトリーもまた、これらとは違う要件を突きつける。最も大きな違いは「密度」だ。
一般的なデータセンターでは、ラックに収容したサーバー群をトップオブラックやミドルオブラックのスイッチに収容し、そこからのアップリンクで3対1、16対1といった比率に集約する。オーバーサブスクリプションと呼ばれる設計だ。これが成立するのは、つながっている全員が同時に通信するわけではないからである。
ところがAIの演算は、この前提を崩す。処理が終わったサーバーから隣のサーバーへ順にデータを渡していくのではなく、クラスターを構成する全GPUが同時に通信を始めるからだ。全ノードが同時に全帯域を使い切ることを前提とした、いわゆる「フルバイセクション」のネットワークを組まざるをえない。
同じポート数、同じ回線速度であっても、フルバイセクションを前提にすればネットワーク中央部の密度は跳ね上がる。この密度が、電力の問題を呼び込む。
通信の消費電力を減らした分、AIの性能が上げられる
従来のクラウドデータセンターでは、ネットワーク設備が全体の消費電力に占める割合は数%程度にすぎなかった。ところがAIのために必要な帯域を確保し、密度の高いネットワークを構築すると、その割合は現時点で全体の10%程度にまで上昇するという(図表2)。
図表2 従来型クラウドデータセンターとAIファクトリーのネットワーク比較
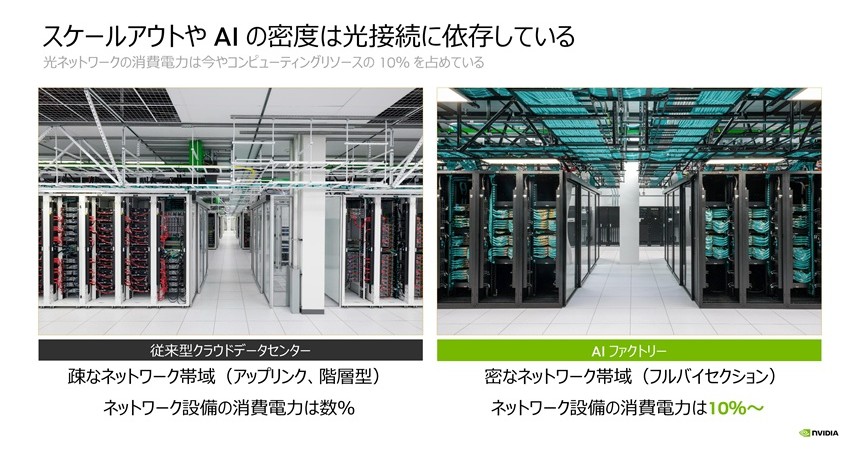
帯域を確保するには、銅線で信号を引き回せる距離を超えた接続を大量に用意しなければならない。必然的に、SFPやOSFPといったレーザーモジュールを使って光ファイバーでつなぐことになる。しかもその本数は、GPUの数だけ必要になる。
この10%という数字を、どう受け止めるか。「所詮10%だよねって考える人もいるかもしれない」と愛甲氏は言うが、エヌビディアはそう考えていないという。
データセンターに供給できる電力には上限がある。電力バジェットと呼ばれるこの枠のうち10%を通信が消費しているのなら、それを5%に減らせば、浮いた分だけ計算機を増やせる。すなわちAIの性能が上げられる――。ネットワークの消費電力を削ることが、そのままAIの出力を増やし、価値を高めることにつながる。
1.6Tbps当たりの消費電力は25Wから5Wに
そこで登場するのが、シリコンフォトニクスであり、CPO(Co-Packaged Optics)だ。着脱式のプラガブル光トランシーバーを使わず、チップ上で直接光変調を行う。
通信部分で最も電力を消費しているのは、レーザーだ。これを何とかしようというのがCPOの狙いである。
CPOの技術そのものは以前から確立しており、チップベンダーの試作品もかなり以前から存在していた。だが、製品化にこぎ着けたのはエヌビディアが業界初だという。
従来のプラガブルスイッチの構成では、サブストレートに実装されているASICから伸びた配線が、基板を通ってフロントパネルのケージまで信号を運ぶ。愛甲氏によれば、同社のあるスイッチの実測値では、200Gbps級の信号をこの経路で外に出す際に、平均20dBを超える損失が筐体の中だけで発生するという。
この損失を補うために、トランシーバーの直前でDSPによるリタイミングをかけ、アンプを入れる必要が生じる。その1つひとつが電力を消費する。ポート数の多い高密度スイッチであれば、同じ回路が数百個並ぶことになる。
図表3 従来のプラガブル構成とコパッケージドオプティクスの比較
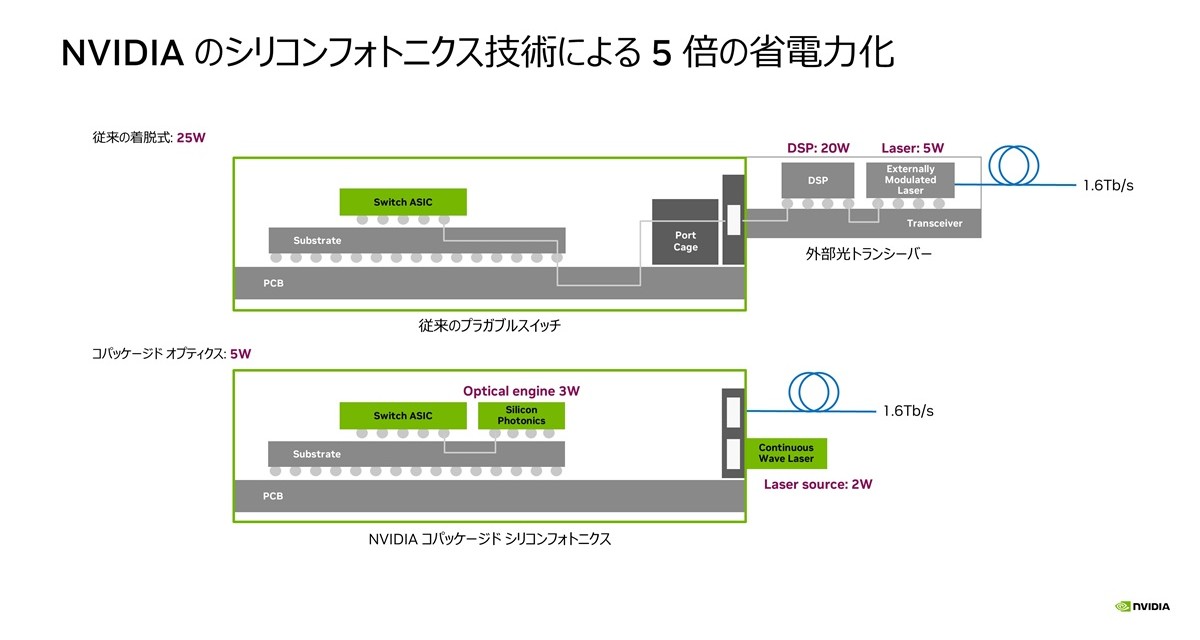
これに対し、CPOではサブストレート上に光エンジンを載せ、外部光源とチップ上の変調器だけで信号を扱う。損失はせいぜい3~4dB程度に収まり、そのまま変調をかけられるため、DSPリタイマーが不要になる。
結果として、1.6Tbps当たりの消費電力は従来のプラガブル構成の25W(DSPが20W、レーザーが5W)から、光エンジン3W、レーザー光源2Wのわずか計5Wへと下がる(図表3)。必要なレーザーの本数も、1.6Tbps当たり8本から2本へと減る。
愛甲氏によれば、現行の実装技術でも、同じ電力バジェットでより大きなネットワークを構築でき、より多くのGPUを搭載できるという。
画像クリックまたはQRコード読み取りで、NVIDIA CPO紹介映像が閲覧できる
エヌビディアの実装では、レーザー光源を外部のOSFPモジュールとしてスイッチ前面に配置し、ファイバーでスイッチASICに導く。信号の変調はチップ上のマイクロリング変調器が担う。このシリコンフォトニクスエンジンはTSMCのプロセスを用いた3次元積層構造で、1.6Tbpsに対応するCPOチップとしては世界初をうたう。スイッチ本体は液冷に対応する。
CPOのメリットは「電力だけではない」、システムの信頼性も向上
CPOがもたらすメリットは電力だけではない。エヌビディアはこれを6項目に整理している(図表4)。
図表4 CPOがもたらす6つのメリット
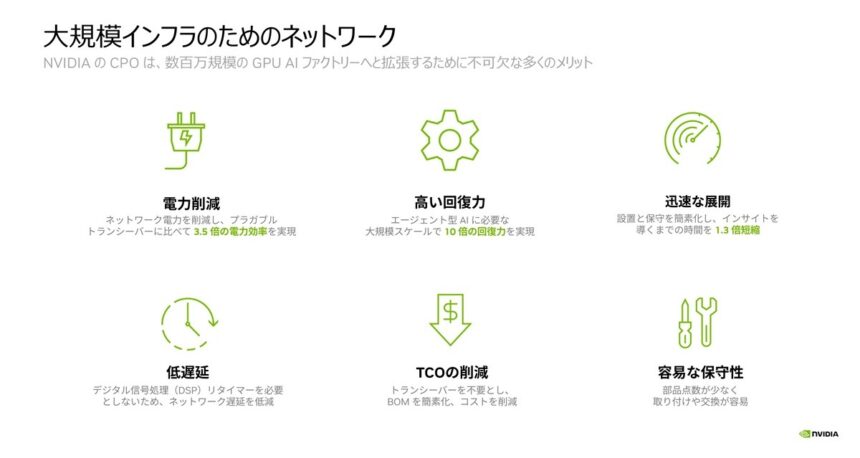
まず信頼性だ。外部レーザーやDSPが減ることで、故障の起点そのものが減る。同社の推定値では、システムとしてのMTBF(平均故障間隔)は従来構成の5倍程度が期待できるという。
この差は、大規模構成で顕著になる。愛甲氏は、10万GPU規模のAIインフラを従来のプラガブルトランシーバーで構築した場合、計算上は数日に1回はどこかが故障し、交換が必要になると指摘した。CPOであれば、推定値としてその10倍、50日程度は持つのではないかという。「この期間が長く延びるというのは、AIが連続して稼働することができる時間が延びるという、非常にシンプルにわかりやすいメリット」だ。
CPOの弱点として指摘されることが多い保守性についても、エヌビディアは必要な手当てをすでに行っている。チップと光ファイバーが直結していると分解も交換もできないのではないか――。愛甲氏もこの点はよく質問を受けると言うが、実際にはコネクターになっており、取り外しが可能だ。同氏は、修理も交換も通常の製品と同じように行えることを強調した。
さらに、部品点数が減ることは、構築期間にも影響する。同社自身のデータセンター構築では、モジュールの数量が減ったことで3割程度は早くなったという実績があったと愛甲氏は明かした。トランシーバーが減る分、保守コストも下がり、TCOの削減につながる。
なお、これらのコネクターやファイバーには日本メーカー製が採用されている。愛甲氏は「日本の優秀なパートナーの皆様方の技術を使わせていただいております」と述べ、日本企業の技術力に触れた。センコーアドバンスや住友電工をはじめ、レーザー光源やファイバー、マイクロオプティクスで複数の企業が製品化に関与している。
図表5 NVIDIAフォトニクスの概要
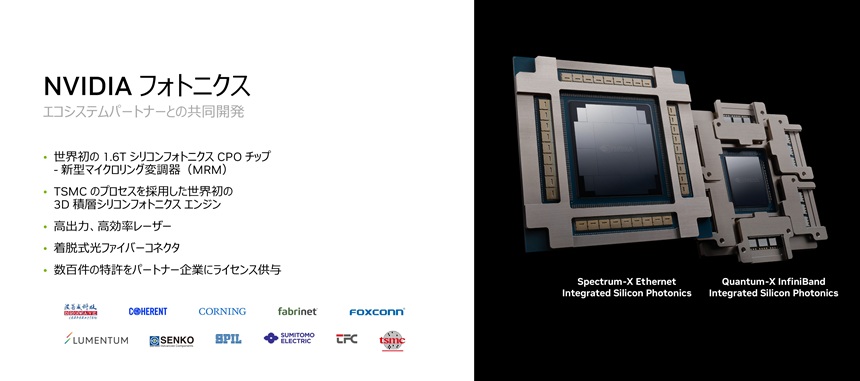
CPOを搭載した製品としては、InfiniBand向けの「Quantum-X フォトニクス」と、イーサネット向けの「Spectrum-X フォトニクス」が用意される。前者はスイッチ容量115Tbpsで800GbE換算144ポート、後者は102.4Tbpsで128ポートの1Uモデルと、409.6Tbpsで512ポートを収容する8Uのシャーシ型モデルがラインアップされている。いずれも液冷に対応する。
求められる「全体最適」の視点
もっとも、CPOだけですべての電力問題が解決するわけではない。
愛甲氏は一例として、米国で進む800V DC給電を挙げた。電流を減らすために電圧を上げる考え方で、米国では既定路線になりつつあるが、日本では750V超が高圧区分となるため、そのまま持ち込むことはできない。
データセンターの電力、空調、そして実際に価値を生むアウトプット。これらを個々にピンポイントで見ていても仕方がなく、全体で改善していくことが今後いっそう求められる、というのが愛甲氏の見立てである。
AIは多階層のインフラであり、層単独の最適化では機能しない。求められるのは、AIの出力をいかに効率よく得られるかというKPIに基づく全体最適である。ネットワークが速い、CPUが速い、GPUが速いという個別の指標ではなく、トータルで何が得られるか――。アプリケーション・スペシフィックかつサービス・ドリブンな発想への転換を、愛甲氏は聴衆に求めた。
そうしたAIファクトリーの設計思想が、ネットワークの評価軸と設計・構築法をどのように書き換えていくのか。その行方を注視しておきたい。
<お問い合わせ先>
エヌビディア合同会社
お問い合わせ窓口:https://nvj-inquiry.jp/